문서 인식과 생성
문서에 담긴 내용을 업무 데이터로
OCRKit문서 인식과 생성
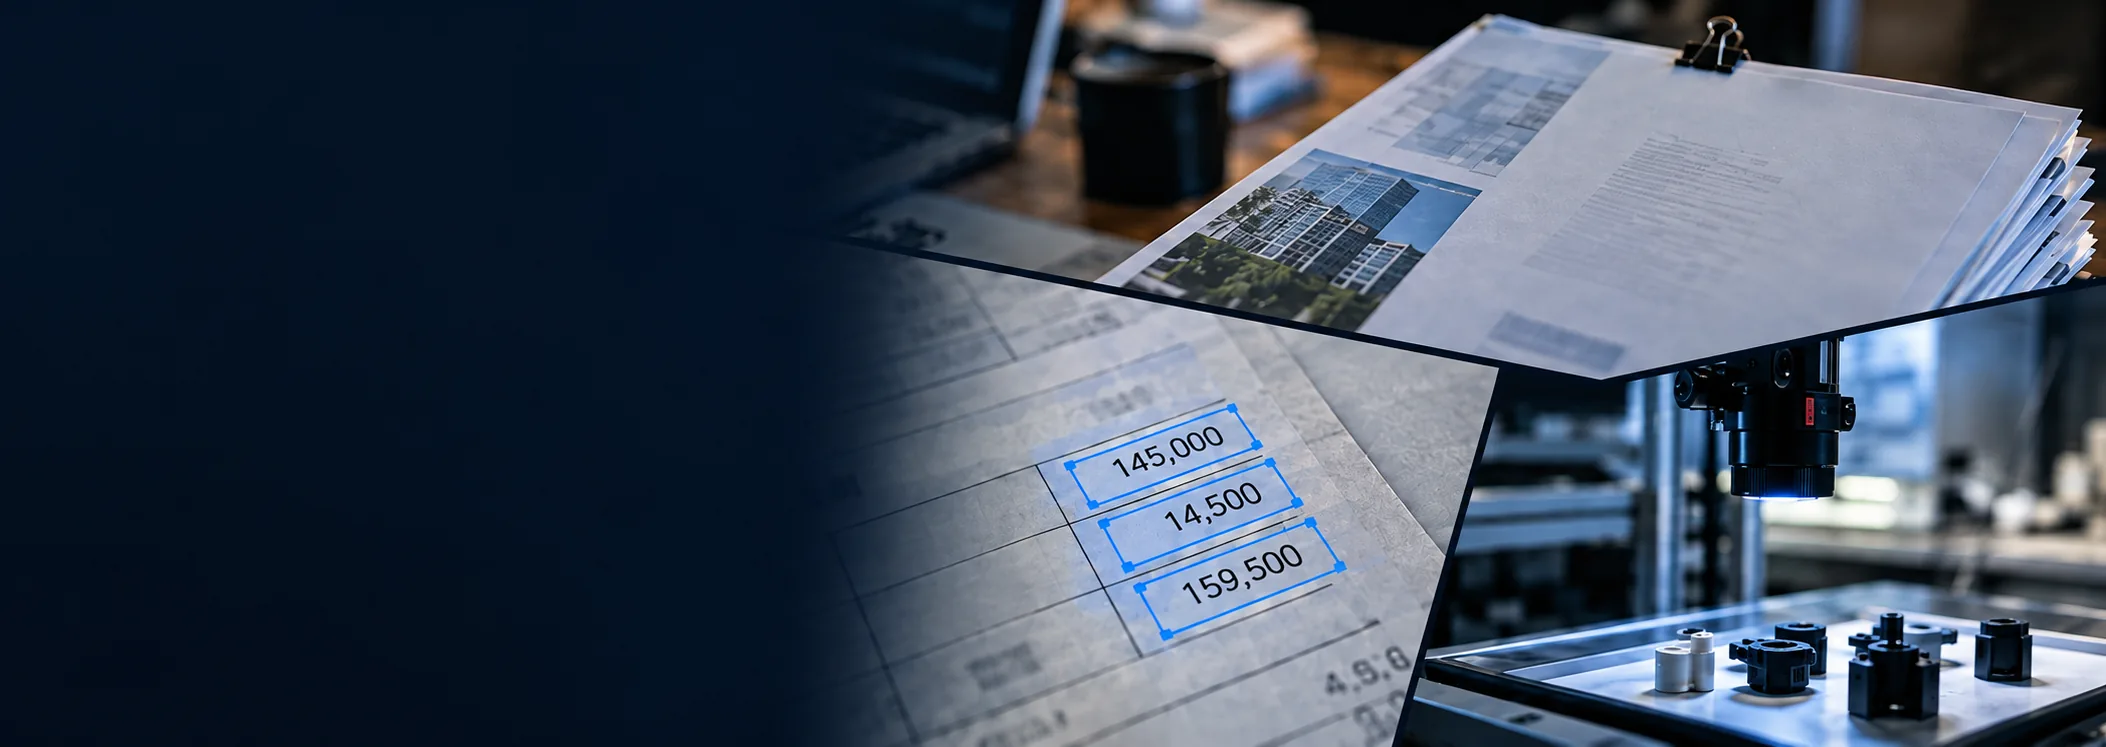
문서의 텍스트, 표, 조문 계층을 읽어 업무 데이터로 활용하고, Markdown 본문이나 기관 양식으로 한글 문서를 만듭니다.
문서 인식, 한글 문서 생성, 기관 양식 채우기를 체험할 수 있습니다.
공문, 보고서, 규정에서 본문과 표, 조문 계층을 추출해 원본과 대조하고, 기관 양식에 값을 채워 공문을 만드는 업무에 활용할 수 있습니다.
샘플 또는 업로드한 문서의 실제 처리, Markdown 문서 생성, 양식 채우기와 서식 보존 수정을 실제 API로 체험합니다. 부분 결과와 실패 단계도 그대로 표시합니다. API가 연결되지 않은 환경은 오프라인 샘플로 표시합니다.
Studio에서 실제로 실행한 결과 화면입니다. 원본 제품 화면도 함께 볼 수 있습니다.
도입을 검토할 때 먼저 확인하는 세 가지입니다.
HWP 전 계열과 PDF, 이미지, Office, HTML을 하나의 API로 읽어 Markdown과 구조화된 JSON으로 바꿉니다. 한글 문서는 원문 구조 파싱을 먼저 시도해 글자를 원본 그대로 옮기고, 기관 양식 HWPX는 표지와 서체, 여백을 그대로 둔 채 내용만 채워 돌려줍니다.
OCRKit 문서 인식과 생성문서 처리와 워크플로 엔진은 컨테이너로 사내에 배포합니다. 모델 호출 키는 서버에서만 관리해 브라우저로 내려보내지 않고, 작업 결과는 정해진 보관 기간이 지나면 삭제됩니다.
Studio 콘솔 정책과 QORE 온프레미스 구성모델 비교와 답변 평가는 항목별 점수와 Judge의 판정 이유를 문장으로 남깁니다. 모든 실행은 요청 이력에 기록되고 JSON과 CSV로 내보내 제안서와 검수 보고서에 그대로 붙일 수 있습니다.
BenchKit, EvalKit, 요청 이력제품 소개에서 입력과 결과를 확인하고,
Studio에서 직접 체험할 수 있습니다.